01 - 选型与基线
这一篇是操作步骤,不是背景介绍。 从头到尾七步,前四步在自己电脑上做(不花钱),后三步在租来的机器上做(约 $0.5)。做完你手上会有三样东西:一个确定的模型 ID、一个确定的训练框架、一张填好数字的基线表。
没有这三样,第 02 篇的数据没法造,第 03 篇的配置没法写。
一、先看清楚这一篇要解决什么
你打开 HuggingFace 搜 Qwen3,看到一排型号:0.6B、1.7B、4B、8B、14B、32B。
选哪个?
凭直觉会想「选大的效果好」。但两件事会拦住你:大模型装不进 24G 显存,而且装得进不等于训得出来。更麻烦的是,这两个问题的暴露时间差得很远 —— 显存不够,开跑五分钟就 OOM 报错,损失是五分钟;模型太小学不会,要等你训完三个小时、跑完评测才发现分数没动。
所以顺序是:先用显存淘汰一批(快、确定),再用能力底线淘汰一批(慢、要动手测)。
二、第 1 步:算显存账,划出可选范围
2.1 训练时显存被谁占了
先弄清楚一件事:训练比推理吃显存得多。 推理只需要装下模型权重加一小块缓存;训练除了权重,还要存梯度、存优化器状态、存前向过程中的中间结果。
用 LoRA 微调的时候,这四项的大小是:
| 项 | 怎么算 | 4B 模型上是多少 |
|---|---|---|
| 模型权重 | 参数量 × 2 字节(bf16) | 8.0 GB |
| LoRA 参数 + 它的优化器状态 | 只有百分之零点几的参数在训 | 不到 0.5 GB |
| 激活值 | 随序列长度和 batch 变 | 约 3.5 GB(seq 2048、batch 2) |
| 杂项 | CUDA context、显存碎片 | 约 1 GB |
第二行是 LoRA 全部的意义所在。 如果做全参微调,这一行要变成「梯度 8 GB + AdamW 的动量和方差 24 GB」—— 光优化器状态就是权重的 6 倍,4B 模型直接要 40 GB 以上,24G 卡想都别想。LoRA 冻住原权重、只训一小撮新加的参数,把这一行从 32 GB 压到 0.5 GB。
把两个候选并排放,同样是 seq 2048、batch 2:
| 项 | Qwen3-4B | Qwen3-8B |
|---|---|---|
| bf16 权重 | 8.0 G | 16.0 G |
| LoRA 参数 + 优化器状态 | 0.4 G | 0.7 G |
| 激活值 | 约 3.5 G | 约 3.5 G |
| 杂项 | 约 1 G | 约 1 G |
| 合计 | 约 12.9 G | 约 21.2 G |
| 24G 卡上的余量 | 约 11 G | 不到 3 G |
第二行就是 LoRA 全部的意义所在 —— 它小到在这张表里几乎可以忽略。换成全参微调,这一行在 4B 上要变成 32 G(梯度 8 G + AdamW 的动量和方差 24 G),整列直接溢出。
2.2 LoRA 到底冻住了什么
上面那句「LoRA 冻住原权重、只训一小撮新加的参数」,值得看清楚它具体是怎么做的 —— 03 篇要调的 lora_rank 就是这张图里的 r。
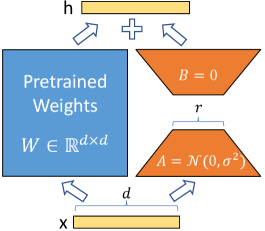
三件事从图上直接读得出来:
- 左边蓝色的 W 全程冻结。 它照样参与前向计算(所以 8 G 显存省不掉),但不产生梯度,也就不需要优化器状态 —— 省掉的是那 32 G,不是那 8 G
- 右边是一条旁路:
x → A → B → 加回 h。中间那个 r 是瓶颈维度,d × d的大矩阵被换成了d × r和r × d两个瘦长矩阵。r 取 16、d 取 2560 时,参数量是原来的 1.2% - B 初始化为 0。 所以训练刚开始时旁路输出恒为 0,模型行为和原模型一模一样。这是 LoRA 不会一开跑就把模型搞坏的原因,也是它可以用比全参高两个数量级的学习率的原因
2.3 那为什么不用别的省显存办法
省显存的手段不止 LoRA 一种。它们的差别不在「省多少」,而在牺牲了什么:
| 做法 | 24G 上能不能跑 4B | 牺牲了什么 | 什么时候选 |
|---|---|---|---|
| 什么都不改,全参微调 | 不能,要 40 G 以上 | —— | 有 80 G 卡且要改模型的知识 |
| LoRA | 能,余量约 11 G | 表达能力上限(只能在低秩子空间里改) | 学行为模式,这个项目 |
| QLoRA(权重量化到 4bit) | 能,余量更大 | 精度,且训练慢一到两成 | 显存实在不够,或想上 8B 以上 |
| 梯度检查点 | 能,但只省激活那 3.5 G | 速度,约慢三成 | 序列特别长的时候叠加用 |
| 只改 prompt,不训练 | —— | 学不到判断,只能靠说明书 | 先试这个,五分钟能验证 |
最后一行才是真正该先试的。 微调一轮要半天加真金白银,改 prompt 五分钟就知道行不行。等 prompt 已经写到自相矛盾还压不住错误率,才轮到 LoRA。
不选 QLoRA 的理由是这个项目不缺显存。4bit 量化会让权重本身有损,而你正在评测的是一个小模型的判断力 —— 再叠一层精度损失,分数变化里就混进了说不清的来源。先把变量控制住,省显存的手段留到真的不够用时再上。
2.4 这一步的结论
| 模型 | 24G 上能不能 LoRA | 判断 |
|---|---|---|
| Qwen3-0.6B / 1.7B | 轻松 | 显存不是问题,问题在能力,见第三节 |
| Qwen3-4B | 舒服,余量约 11 G | 候选 |
| Qwen3-8B | 勉强,余量不到 3 G | 能跑,但没有调参空间 |
| Qwen3-14B 及以上 | 装不下 | 出局 |
看到 4B 还剩 11 G,第一反应可能是「太浪费了,上 8B」。但训练中显存占用是波动的:某条样本特别长、梯度检查点没配好、框架内部临时开一块缓存,都会顶上去一截。
余量不足的代价不是慢,是第三小时突然 OOM 崩掉。 如果没配 checkpoint,前三小时全白跑。
三、第 2 步:判断模型「学不学得会」,定下 base
显存这关过了三个候选:0.6B、1.7B、4B。接下来的问题是:它们学不学得会?
3.1 SFT 能教什么,教不会什么
这里有个初学者常见的误解,值得先讲清楚。
微调(SFT)的过程,本质是给模型看几千条「这种情况下应该这样回」的例子,让它把这个模式记下来。它擅长把模型已经会一点的东西调稳定,不擅长凭空教会一个全新的能力。
具体到工具调用,这件事拆成两半:
- 格式:怎么输出一个合法的 tool call —— 字段名、JSON 结构、特殊 token。这半边是死记硬背,再小的模型都能学会
- 判断:这个问题该不该调工具、该调哪个、参数从用户哪句话里抠 —— 这半边需要理解语义,base 模型本来就得有一点,SFT 才能把它放大
下面那条路不是白跑 —— 格式确实修好了。坑在于它看起来像成功:格式合规率从 40% 涨到 99%,而真正决定 Agent 好不好用的任务成功率一动没动。这也是下一节要把指标拆成四层的原因。
3.2 三个候选怎么落地
| Base | 工具调用的起点 | 结论 |
|---|---|---|
| Qwen3-0.6B | 基本只能背格式,判断层接近随机 | 训完是右边那条路,出局 |
| Qwen3-1.7B | 简单单轮能对,多轮和参数抽取不稳 | 能训,但天花板低 |
| Qwen3-4B | 单轮稳、多轮偶尔丢上下文 —— 正好是「会一点」 | 选它 |
为什么不选 8B:能力当然更好,但不到 3 G 的余量意味着你没有调参空间。第一轮跑完想把 seq 从 2048 拉到 4096 看看效果,直接 OOM,只能重开一台更大的机器。第一个项目的目标是把链路跑通,不是把分数刷高。
3.3 为什么是 Qwen3 这一系,不是别家
三个具体理由,都和「省事」有关:
- 它的 chat template 原生带 tools 字段。 你不用自己发明一套工具调用的文本格式 —— 发明了就得在训练和推理两边各实现一遍,两边不一致是这个项目最常见的翻车方式
- 训练框架和推理框架都默认支持它。 LlamaFactory、ms-swift、vLLM 都内置了 Qwen 的模板和解析器,不用改代码
- 中文任务上不吃亏。 你的工具描述和用户问题大概率是中文
Qwen3 支持在回答前输出一段思考内容。这段内容要不要放进训练数据,是第 02 篇必须先定下来的事 —— 定错了,训练时的样本格式和推理时对不上,模型会在该输出工具调用的地方输出思考文本。
现在先记住有这回事,02 篇会给出选择依据。
记下来:base 模型 = Qwen/Qwen3-4B。后面所有配置都以它为准,中途别换 —— 换了基线就得重测。
四、第 3 步:挑训练框架
4.1 五个候选,差别在「封装厚度」
现在能用来做 LoRA SFT 的框架不少。它们的功能大同小异,真正的差别是替你做了多少事 —— 替你做得越多,跑通越快,但出问题时你越不知道该看哪里。
以下 star 数和最近提交时间为 2026-09-03 用 gh api 实测:
| 框架 | star | 替你做了什么 | 代价 |
|---|---|---|---|
| unsloth | 75.5k | 手写 kernel,显存和速度优化到极致 | 对多轮 + 工具调用数据的支持要自己确认,出问题几乎无从查起 |
| LlamaFactory | 74.5k | 一个 YAML 配置文件跑通全流程,内置几十种模型模板和数据格式 | 封装厚,loss 怎么算的藏在几层调用之下 |
| verl | 23.3k | 面向 RL 的完整训练链路 | 这个项目用不上,第二个项目会回来找它 |
| trl | 19.2k | HuggingFace 官方,只封装训练循环 | 数据处理、模板拼接全要自己写 |
| ms-swift | 15.5k | 和 LlamaFactory 定位接近,魔搭生态 | 同上 |
4.2 选 LlamaFactory,以及怎么补上它遮住的东西
第一个项目选 LlamaFactory。 理由是它内置了带工具调用的数据格式和 Qwen3 的模板 —— 这两件事自己实现,是这个项目最容易出错也最不值得从零做的部分。
代价是它把 loss mask 这类关键细节藏起来了,而那恰恰是你该理解的东西。补的办法很简单,也是这个专题唯一要求你读源码的地方:
第一轮训练跑通后,去看 LlamaFactory 里构造训练样本那段代码,重点看它怎么决定「哪些 token 参与 loss 计算」。这段逻辑在 03 篇会讲原理,读一遍实现能让它落地。
只要求读这一段,不要求读全部。
记下来:训练框架 = LlamaFactory。
五、第 4 步(本地):准备基线评测集
5.1 先明确「基线」是什么
基线就是训练之前,base 模型在你的任务上的分数。
为什么非要有它:训完之后你会得到一个数字,比如任务成功率 55%。这个数字单独看毫无意义 —— 可能 base 本来就有 52%,你花三小时换了 3 个点;也可能 base 只有 20%,那是一次成功的训练。没有基线,训练结果无法解读。
5.2 四层指标
评测不能只看「任务有没有做成」。做不成的时候,你需要知道是哪一环断的,否则不知道该补什么数据。
拆成四层,从浅到深:
| 层 | 指标 | 判定方式 | 断在这一层说明 |
|---|---|---|---|
| L1 | 格式合规率 | 输出能否被解析成合法 tool call | 模板或特殊 token 没学对 |
| L2 | 工具选择正确率 | 选的工具名对不对 | 工具描述写得不够区分 |
| L3 | 参数正确率 | 必填参数齐不齐、类型对不对、值抽对没 | 从用户话里抽信息的能力不够 |
| L4 | 任务成功率 | 端到端跑完,结果对不对 | 多轮规划或错误恢复的问题 |
这四层是逐级依赖的:L1 不过,后面三层全是 0。所以看分数要从左往右看,第一个明显偏低的地方就是当前的瓶颈。
5.3 准备 20 到 50 条任务
数量不用多,关键是覆盖面。按这几类各准备几条:
| 类别 | 例子 | 测的是 |
|---|---|---|
| 单轮直球 | 「查一下北京今天天气」 | L1 / L2 基本能力 |
| 需要抽参数 | 「查华东区上个月的退款订单」 | L3 |
| 不该调工具 | 「你好,你是谁」 | 会不会滥用工具 |
| 多轮带指代 | 第一轮说华东区,第三轮问「那广东呢」 | 上下文保持 |
| 工具会报错 | 查一个不存在的订单号 | 错误恢复 |
| 需要连调两次 | 先查用户 ID,再用 ID 查订单 | L4 规划 |
每条任务要写清楚期望的工具调用和期望的最终结果,否则没法自动判分。具体的 JSON 格式在 02 篇和训练数据一起定,两边共用同一套工具定义。
这一步在自己电脑上做,不花机时。 写这 30 条任务大概要一两个小时,是整个项目里最枯燥但最保值的部分 —— 后面每一轮训练都用它复测。
六、第 5 步:为什么基线必须在租来的机器上量
写完评测集,你可能想直接用 API 调一个 Qwen3-4B 把基线测了 —— 便宜、快、不用开卡。
这样测出来的基线不能用。
原因是:训练之后你会在租来的机器上用 vLLM 部署模型再测一遍。两次测量如果用了不同的推理栈,采样参数、chat template 的实现细节、量化精度都可能不一样,分数差里就混进了「换栈」带来的差异,而你分不清哪部分是训练的功劳。
上面那条路里,采样参数、chat template 的实现细节、量化精度三处都不同,分数差里混进了换栈带来的差异。下面那条路多付的只是训练前那 20 分钟评测,约 $0.15。
这是整个项目里唯一一处「顺序错了就要重开机器」的地方 —— 基线漏测,等训完才想起来,得把 LoRA 卸掉重新起一次服务,多付一次十分钟的冷启动。
七、第 6 步:开卡,起 vLLM,量基线
从这里开始计费。目标是 40 分钟之内量完基线。
7.1 挑机器与开机
按 Runtime-Profiling 01 篇的清单筛,这个项目额外要确认两条:
| 要确认 | 为什么 |
|---|---|
| CUDA 版本满足 vLLM 和 PyTorch 的要求 | 对不上要在装依赖上耗掉几小时机时 |
| 磁盘 ≥ 60 GB | Qwen3-4B 权重约 8 GB,加上依赖和 checkpoint |
7.2 下载模型并起服务
# 先把权重拉下来。放在持久化目录,实例重启后不用重下。
# 注意:命令行工具从 huggingface-cli 改名成了 hf,老教程里的写法可能对不上。
hf download Qwen/Qwen3-4B --local-dir /workspace/models/Qwen3-4B
# 起推理服务。三个参数是为这个项目专门配的,逐条说明:
#   --gpu-memory-utilization 0.85
#       给 vLLM 划走 85% 显存。剩下的 15% 不是浪费 —— 后面训练要用同一张卡,
#       现在留够余量,等下不用重启服务。
#   --enable-auto-tool-choice + --tool-call-parser hermes
#       让 vLLM 把模型输出里的工具调用解析成结构化的 tool_calls 字段。
#       不加这两个,返回的是一坨纯文本,你得自己写正则去抠 ——
#       而自己抠的规则和训练时的格式一旦对不上,测出来的 L1 分数就是错的。
#       Qwen 系用 hermes 这个 parser。
vllm serve /workspace/models/Qwen3-4B \
  --served-model-name qwen3-4b \
  --max-model-len 8192 \
  --gpu-memory-utilization 0.85 \
  --enable-auto-tool-choice \
  --tool-call-parser hermes
日志最后出现监听 8000 端口的字样就是起来了。首次启动要编译和加载权重,十分钟左右是正常的,别以为卡死了。
启动时如果 OOM,是 --max-model-len 开太大、KV cache 预分配放不下,降到 4096 就行。
7.3 跑基线
# 用 OpenAI 兼容接口调本机的 vLLM。
# 关键:这里的采样参数要记下来,训练后复测必须一字不差地用同一套,
#      否则两次分数不可比 —— 这就是上一节那张图讲的事。
from openai import OpenAI

client = OpenAI(base_url="http://localhost:8000/v1", api_key="EMPTY")

resp = client.chat.completions.create(
    model="qwen3-4b",
    messages=[{"role": "user", "content": "查一下华东区上个月的退款订单"}],
    tools=TOOLS,          # 第 02 篇定义的工具集,训练和评测共用同一份
    temperature=0.0,      # 评测必须关掉随机性,否则同一题两次跑分不一样
    max_tokens=512,
)
对每条任务跑一遍,按 5.2 的四层分别记分。
带随机性的采样会让同一个模型在同一道题上时对时错。你会把随机波动误读成训练效果 —— 尤其在只有 30 条任务的小评测集上,波动能有好几个点。
7.4 把基线记下来
这张表是这一篇的最终产出,跑完立刻填,别等:
| 项 | 值 |
|---|---|
| 测量日期 | 待填 |
| 机器型号 / CUDA 版本 | 待填 |
| vLLM 版本 | 待填 |
| 模型路径与 revision | 待填 |
| 采样参数 | temperature=0, max_tokens=512 |
| 评测集条数 | 待填 |
| L1 格式合规率 | 待填 |
| L2 工具选择正确率 | 待填 |
| L3 参数正确率 | 待填 |
| L4 任务成功率 | 待填 |
| 本次机时与花费 | 待填 |
中间四行是核心,其余几行是为了将来能重现这次测量。半个月后你想不起来当时用的哪个 vLLM 版本,这张表就是唯一的依据。
八、第 7 步:决定停机还是接着训
基线量完,两个选择:
一是结果已经拷走 —— 市场型平台上停机后机器就放回池子了,明天未必还租得到同一台。
二是存储费在按天扣。100 G 的盘放着不用,几天的存储费就超过这次评测的算力费。确定不用了就整个销毁。
九、这一篇的验收清单
全部打勾才能进入下一篇:
- base 模型确定为
Qwen/Qwen3-4B,理由是显存余量和「会一点」这两条 - 训练框架确定为 LlamaFactory
- 20 到 50 条基线任务写完,六个类别都有覆盖
- 每条任务都写清了期望的工具调用和期望结果
- 在租来的机器上用 vLLM 跑完基线,四层分数全部记录
- 采样参数、vLLM 版本、机器型号记进了 7.4 那张表
- 结果文件已拷回本地
最容易漏的是倒数第二条。 它当下看着没用,等你训完第二轮想和第一轮比的时候,才会发现自己根本不记得当时是怎么测的。